
Pandas از کتابخانه های متن بازی است که برای کار با داده هایی با ساختار رابطه ای (rational) یا برچسب گذاری شده ایجاد شده است. این کتابخانه ساختار داده های متنوعی به همراه امکان اعمال عملیات عددی روی این داده ها را فراهم می کند وبه خوبی می تواند با سری های زمانی کار کند. Pandas بر مبنای کتابخانه ی NumPy ساخته شده است و بسیاری از ساختار های NumPy در این کتابخانه استفاده شده و گسترش یافته اند. در ادامه به آموزش کتابخانه Pandas می پردازیم. مزایای این کتابخانه شامل موارد زیر است:
- سرعت و کارایی بالا در کار با داده ها.
- امکان بارگذاری داده ها از فایل های متفاوت.
- کنترل راحت ویژگی هایی که مقداردهی نشده اند. (به عبارتی این مقادیر با NaN مقداردهی شده اند.)
- قابلیت تغییر اندازه: ستون هایی می توانند به داده ها اضافه شوند و یا از آن ها حذف شوند.
- ادغام (merge) و اتصال (join) مجموعه داده ها.
- تغییر شکل داده به طور منعطف.
- فراهم کردن امکان کار با سری های زمانی.
- امکان گروه بندی داده ها با توجه به اهداف کاربردی.
محیطی که در این مقاله برای کار انتخاب کرده ایم JuputerNotebook است که از توزیع آناکوندا استفاده شده است. برای توضیحات بیشتر و نحوه ی نصب آن به این مقاله مراجعه کنید.
ساختار داده ها در کتابخانه Pandas
به طور کلی کتابخانه Pandas دارای دو دسته ساختار داده است:
- سری یا Series
- دیتافریم یا DataFrame
البته نوع سومی تحت عنوان Panel هم بود که در نسخه های جدید منسوخ شده است.
نوع داده ی Series
سری یک آرایه ی یک بُعدی و برچسب گذاری شده است (دارای ایندکس برای سطرهاست) که می تواند انواع مختلف داده (عدد صحیح، اعشاری، رشته، آبجکت های پایتون و...) را در خود نگه دارد.
به محور برچسب ها اندیس یا index می گویند. سری های کتابخانه Pandas مثل یک ستون از صفحه ی اکسل است. اندیس ها باید منحصر به فرد باشند و هر اندیس فقط به یک عنصر اشاره کند. منبع داده برای سری های کتابخانه Pandas می تواند پایگاه داده ی SQL، فایل های CSV و اکسل باشد. نوع داده ی ورودی سری نیز می تواند به شکل لیست، تاپل و دیکشنری و عدد اسکالر باشد.
ایجاد یک سری: یک سری در پانداس به شکل زیر تعریف می شود:
pandas.Series( data, index, dtype, copy)
که در آن:
- data: داده ی ورودی است که می تواند به شکل آرایه، لیست، دیکشنری یا عدد باشد.
- index: مقدار اندیس یا برچسب اختصاصی به هر سطر است که به طور پیش فرض از اعداد 0 تا n-1 است(n: تعداد داده هاست) و البته می تواند هر مقدار عددی یا رشته ای دلخواه را بگیرد.
- dtype: نوع داده ی اختصاصی به ستون داده است که اگر مقدار ندهیم، خودش از داده ها نوع شان را استنباط می کند.
- copy: کپی از سری ایجاد می کند و مقدار پیش فرض False دارد.
در مثال زیر نحوه ی ایجاد یک سری با استفاده از آرایه را می بینیم.
import pandas as pd
import numpy as np


# Creating empty series
ser = pd.Series()

print(ser)

# simple array
data = np.array(['g', 'e', 'e', 'k', 's'])

ser = pd.Series(data)
print(ser)
Series([], dtype: float64) 0 g 1 e 2 e 3 k 4 s dtype: objectاگر مقدار ستون اندیس را مقداردهی نکنیم مانند مثال بالا به طور پیش فرض از صفر شروع به مقداردهی اندیس ها می کند. می توانیم ستون اندیس ها را با عبارت index=[ ]نام گذاری کنیم:
pd.Series([1., 2., 3.], index=['a', 'b', 'c'])a 1.0 b 2.0 c 3.0 dtype: float64برای مشاهده ی داده های یک سری از دستور values استفاده می کنیم و با index اندیس ها را استخراج می کنیم:
my_series=pd.Series([1., 2., 3.], index=['a', 'b', 'c'])
print(my_series.values)
print(my_series.index)
[1. 2. 3.] Index(['a', 'b', 'c'], dtype='object')داده ی ورودی یک سری می تواند به شکل دیکشنری نیز باشد. کلید های دیکشنری به طور پیش فرض در نقش ستون اندیس ها ظاهر می شوند و اگر مقدار index به عنوان ورودی به کد داده شود، داده های دیکشنری در مقابل اندیس هایی ظاهر می شوند که آن اندیس با مقدار کلید داده در دیکشنری برابر باشد.
import pandas as pd
import numpy as np
data = {'a' : 0., 'b' : 1., 'c' : 2.}
s = pd.Series(data)
print (s)
سری خروجی به شکل زیر است:
a 0.0 b 1.0 c 2.0 dtype: float64می توانیم ستون اندیس را خودمان مقدار دهی کنیم:
import pandas as pd
import numpy as np
data = {'a' : 0., 'b' : 1., 'c' : 2.}
s = pd.Series(data,index=['b','c','d','a'])
print (s)
b 1.0 c 2.0 d NaN a 0.0 dtype: float64نکته: اگر داده به صورت دیکشنری باشد و اندیس سری را خودمان تعریف کنیم، آن اندیسی که در داخل کلیدهای دیکشنری نباشد مقدار NAN می گیرد. (مثل اندیس d در مثال بالا)
انتخاب و دستیابی به عناصر سری با مکان داده
می توان به عناصر با شماره ی اندیس آن ها و یا نام اندیس آن ها در داخل براکت [ ] دسترسی داشت. در مثال زیر پنج عنصر اول را انتخاب می کنیم.
# import pandas and numpy
import pandas as pd
import numpy as np

# creating simple array
data = np.array(['g','e','e','k','s','f', 'o','r','g','e','e','k','s'])
ser = pd.Series(data)


#retrieve the first element
print(ser[:5])
0    g
1    e
2    e
3    k
4    s
dtype: object
در مثال زیر هم به کمک برچسب اندیس به داده دسترسی داریم:
# import pandas and numpy
import pandas as pd
import numpy as np

# creating simple array
data = np.array(['g','e','e','k','s','f', 'o','r','g','e','e','k','s'])
ser = pd.Series(data,index=[10,11,12,13,14,15,16,17,18,19,20,21,22])


# accessing a element using index element
print(ser[16])
o
اندیس دهی به داده می تواند به معنای انتخاب زیرمجموعه ای از داده باشد. در مثال زیر ستونی با نام Name از یک فایل csv را انتخاب می کنیم و با تابع( head(10 به ده عنصر ابتدایی سری، دست می یابیم:
# importing pandas module
import pandas as pd

# making data frame
df = pd.read_csv("nba.csv")

ser = pd.Series(df['Name'])
data = ser.head(10)
data
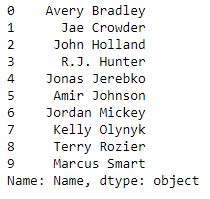
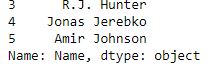
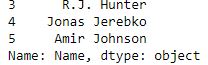
برای دستیابی به عناصر با اندیس 3 و 4 و 5 دستور زیر را می نویسیم:
# using indexing operator
data[3:6]
انتخاب عناصر سری با دستور loc
می توان عدد یا برچسب اندیس های مورد نظر را داخل براکت مقابل [loc[a:b قرار داد. توجه کنید که در اندیس دهی با loc، عدد آخر یعنی b درنظر گرفته می شود. به این مثال توجه کنید:
data.loc[3:6]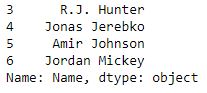
انتخاب عناصر سری با دستور iloc
دستور iloc مشابه loc است با این تفاوت که در [iloc[a:b اندیس ها فقط باید عددی باشند و داده ی مربوط به اندیس عدد b نیز جزو عناصر انتخابی نخواهد بود، همان طور که در کد زیر مشاهده می کنید، عنصر با اندیس 6 جزو خروجی نیست:
# using .iloc[] function
data.iloc[3:6]
اجرای عملیات باینری روی سری ها
عملیات باینری مثل جمع و تفریق و ... را می توان روی سری ها انجام داد:
# importing pandas module
import pandas as pd

# creating a series
data = pd.Series([5, 2, 3,7], index=['a', 'b', 'c', 'd'])
print(data)
# creating a series
data1 = pd.Series([1, 6, 4, 9], index=['a', 'b', 'd', 'e'])
print(data1)
دو سری data و data1 را داریم:
a    5
b    2
c    3
d    7
dtype: int64
a    1
b    6
d    4
e    9
dtype: int64
حال برای جمع data و data1 از دستور add استفاده می کنیم:
data.add(data1, fill_value=0)a 6.0
b 8.0
c 3.0
d 11.0
e 9.0
dtype: float64سایر عملیات دودویی مثل .sub، .mul، .div،.pow و.... نیز وحود دارد که برای مطالعه ی بیشتر می توانید به داکیومنت کتابخانه Pandas مراجعه کنید.
دیتافریم (Dataframe) در کتابخانه Pandas
دیتافریم (Dataframe) یک ساختار داده ی دو بعُدی است و داده ها شامل سطر(یا همان index) و ستون (یا همان columns) است و ساختاری رابطه ای است و هر تعداد داده می توانیم در آن ذخیره کنیم و انواع عملیات محاسباتی و رابطه ای را همچون انتخاب، اتصال و گروه بندی را روی آن انجام دهیم.
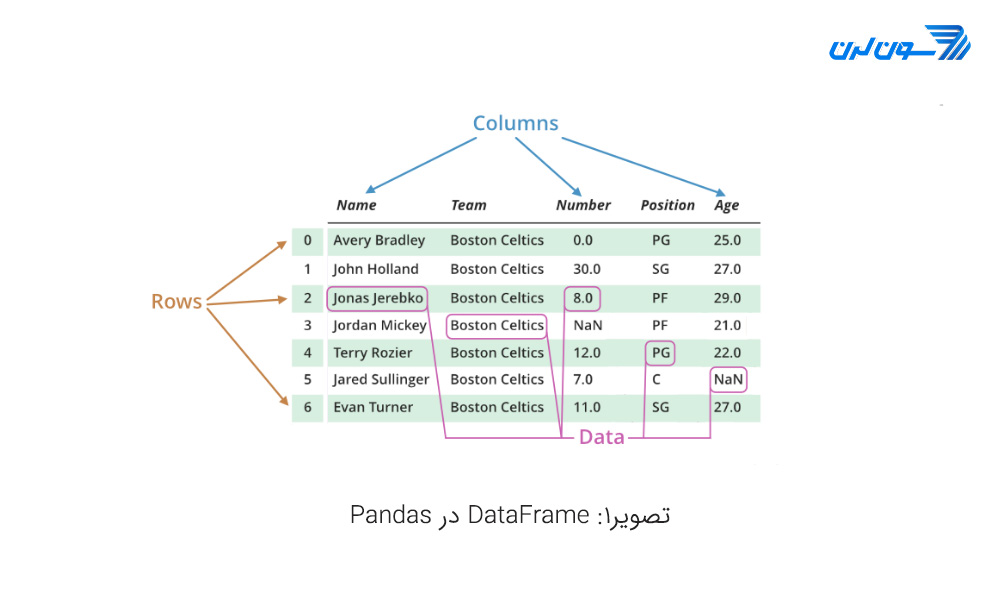
یک دیتافریم (Dataframe) در کتابخانه Pandas (پانداس) به شکل زیر تعریف می شود:
pandas.DataFrame( data, index, columns, dtype, copy)که در آن:
- data: داده ی ورودی است که می تواند لیست، آرایه، مقدار ثابت، دیکشنری و یا یک دیتافریم (Dataframe) باشد.
- index: برای برچسب دهی به سطرها استفاده می شود و اگر مقداری برایش تعریف نشود به طور خودکار از عدد 0 تا n-1 را که n تعداد داده هاست را، می گیرد.
- columns: برای برچسب دهی به ستون ها استفاده می شود و اگر مقداری برایش تعریف نشود به طور خودکار از عدد 0 تا n-1 را که n تعداد ویژگی یا ستون هاست را، می گیرد.
- dtype: نوع ستون ها را برمی گرداند.
- copy: اگر مقدارش True باشد از داده ها کپی ایجاد می کند، اما مقدار پیش فرض آن False است.
دیتافریم (Dataframe) در کتابخانه Pandas (پانداس)، به چند شکل مختلف می تواند ایجاد شود: 1.ایجاد دیتافریم (Dataframe) خالی یک دیتافریم (Dataframe) اولیه می تواند شامل هیچ مقداری نباشد و تنها با متد DataFrame آن را ایجاد کنیم:
# import pandas as pd
import pandas as pd

# Calling DataFrame constructor
df = pd.DataFrame()

print(df)
Empty DataFrame Columns: [] Index: []2. ایجاد دیتافریم (Dataframe) با لیست داده ی دیتافریم (Dataframe) می تواند یک لیست یا لیست های تودرتو باشد:
# import pandas as pd
import pandas as pd

# list of strings
lst = ['this', 'is', 'a', 'practial',
			'article', 'for', 'Pandas']

# Calling DataFrame constructor on list
df = pd.DataFrame(lst)
print(df)
          0
0      this
1        is
2         a
3  practial
4   article
5       for
6 Pandasنکته: پیش از ادامه ی بقیه ی مطالب، یادآور می شویم که در دیتافریم (Dataframe) هم مانند سری ها می توان ویژگی مرتبط با سطرها و ستون ها را مقداردهی کرد.(مقادیر عددی یا رشته ای به index و columns داد.) اما اگر مقداردهی نکنیم به طور پیش فرض عددی و با شروع از صفر مقداردهی می شوند ((numpy.arrange(n :از 0 تا n-1). مثال زیر را ببینید:
# import pandas as pd
import pandas as pd

# list of strings
lst = ['this', 'is', 'a', 'practical',
			'article', 'for', 'Pandas']

# Calling DataFrame constructor on list
df = pd.DataFrame(lst, index=['row1','row2','row3','row4','row5','row6','row7'], columns=['col1'])
print(df)
           col1
row1       this
row2         is
row3          a
row4  practical
row5    article
row6        for
row7     Pandas
3- ایجاد دیتافریم (Dataframe) با دیکشنری
برای اینکه بتوانیم یک دیتافریم (Dataframe) با داده ای از جنس دیکشنری ایجاد کنیم که مقدار اختصاصی به هر کلید از نوع آرایه یا لیست است، باید طول این لیست یا آرایه ها با هم برابر باشند. (اگر index را خودمان مقداردهی کنیم این مقدار باید برابر طول آرایه یا لیست باشد.). کلیدهای دیکشنری برای ستون های دیتافریم (Dataframe) در نظر گرفته می شوند.
# Python code demonstrate creating
# DataFrame from dict narray / lists
# By default addresses.

import pandas as pd

# intialise data of lists.
data = {'Name':['Tom', 'nick', 'krish', 'jack'], 'Age':[20, 21, 19, 18]}

# Create DataFrame
df = pd.DataFrame(data)

# Print the output.
print(df)
خروجی این کد دیتافریمی (Dataframe) به شکل زیر است:
    Name  Age
0    Tom   20
1   nick   21
2  krish   19
3   jack   18
کار با سطرها و ستون ها در دیتافریم (Dataframe)
می توان بر روی دیتافریم (Dataframe) ها عملیاتی چون انتخاب، حذف، افزودن و تغییر نام سطرها و ستون ها را انجام داد.
انتخاب ستون ها: برای انتخاب ستون ها می توان از نام آن ها استفاده کرد. در کد زیر دیتافریمی (Dataframe) با نام df ایجاد می کنیم و سپس ستون های Name و Qualification را انتخاب می کنیم.
# Import pandas package
import pandas as pd

# Define a dictionary containing employee data
data = {'Name':['Jai', 'Princi', 'Gaurav', 'Anuj'],
        'Age':[27, 24, 22, 32],
        'Address':['Delhi', 'Kanpur', 'Allahabad', 'Kannauj'],
        'Qualification':['Msc', 'MA', 'MCA', 'Phd']}

# Convert the dictionary into DataFrame
df = pd.DataFrame(data)

# select two columns
print(df[['Name', 'Qualification']])
Name Qualification
0 Jai Msc
1 Princi MA
2 Gaurav MCA
3 Anuj Phdانتخاب سطرها: سطرهای مورد نظر را می توان با دستور loc یا iloc یا ix انتخاب کرد و البته همان طور که در قسمت Series گفته شد برای انتخاب سطر با iloc تنها از شماره ی برچسب اندیس می توان استفاده کرد. داده های زیر را در نظر بگیرید:
# Import pandas package
import pandas as pd

# Define a dictionary containing employee data
data = {'Name':['Jai', 'Princi', 'Gaurav', 'Anuj'],
        'Age':[27, 24, 22, 32],
        'Address':['Delhi', 'Kanpur', 'Allahabad', 'Kannauj'],
        'Qualification':['Msc', 'MA', 'MCA', 'Phd']}

# Convert the dictionary into DataFrame
df = pd.DataFrame(data,index=('Person1','Person2','Person3','Person4'))
df
دیتافریم (Dataframe) ما در این کد به شکل زیر است:
| Name | Age | Address | Qualification | |
|---|---|---|---|---|
| Person1 | Jai | 27 | Delhi | Msc |
| Person2 | Princi | 24 | Kanpur | MA |
| Person3 | Gaurav | 22 | Allahabad | MCA |
| Person4 | Anuj | 32 | Kannauj | Phd |
حال اگر بخواهیم سطر اول را انتخاب کنیم، با یکی از دو دستور زیر این کار را می توانیم انجام دهیم:
#with loc
df.loc[['Person1']]
#with iloc
df.iloc[[0]]
که خروجی هر دو کد یکسان است:
| Name | Age | Address | Qualification | |
|---|---|---|---|---|
| Person1 | Jai | 27 | Delhi | Msc |
نکته:
یادآوری می کنیم که iloc تنها با اندیس های عددی کار می کند و متد loc با اندیس تعریف شده در جدول.
به دو جفت براکت کنار هر متد دقت کنید: اگر تنها یک جفت براکت بگذاریم خروجی به شکل ستونی زیر چاپ می شود:
Name Jai Age 27 Address Delhi Qualification Msc Name: Person1, dtype: objectاگر بخواهیم دو سطر اول و دوم را انتخاب کنیم مانند کد زیر عمل می کنیم:
#with loc
df.loc['Person1':'Person2']
#or
df.loc[['Person1','Person2']]
#with iloc
df.iloc[0:2]
| Name | Age | Address | Qualification | |
|---|---|---|---|---|
| Person1 | Jai | 27 | Delhi | Msc |
| Person2 | Princi | 24 | Kanpur | MA |
و برای انتخاب سطر اول و اول و ستون دوم و سوم:
#with loc
df.loc['Person1':'Person2','Age':'Address']
#or
df.loc[['Person1','Person2'],['Age','Address']]
#with iloc
df.iloc[0:2,1:3]
| Age | Address | |
|---|---|---|
| Person1 | 27 | Delhi |
| Person2 | 24 | Kanpur |
نکته: اگر ایندکس سطرها به صورت عددی بود، loc را مانند iloc می نویسیم با این تفاوت که در loc عدد اندیس آخر را درنظر می گیریم. یعنی مثلاً برای انتخاب سطر اول و دوم دستور را به صورت [loc[0:1 می نویسیم، درحالی که برای iloc به شکل [0:2]iloc است.
دسترسی به دیتافریم (Dataframe) با اندیس دهی بولین
برای دسترسی به دیتافریم (Dataframe) با اندیس بولین، باید دیتافریم ها (Dataframe) را با اندیس بولین ایجاد کنیم. یعنی دیتافریمی (Dataframe) با اندیس هایی که مقادیر آن True یا False باشد. به طور مثال:
# importing pandas as pd
import pandas as pd

# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["MBA", "BCA", "M.Tech", "MBA"],
        'score':[90, 40, 80, 98]}

df = pd.DataFrame(dict, index = [True, False, True, False])

print(df)
شکل این دیتافریم (Dataframe) به صورت زیر است:
         name  degree  score
True   aparna     MBA     90
False  pankaj     BCA     40
True   sudhir  M.Tech     80
False   Geeku     MBA     98
دسترسی به عناصر دیتافریم (Dataframe) با اندیس بولین همچون سایر دیتافریم ها (Dataframe) به یکی از روش های loc و iloc است. برای دسترسی با loc مقدار True یا False را به عنوان پارامتر ورودی ارسال می کنیم.
# importing pandas as pd
import pandas as pd

# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["MBA", "BCA", "M.Tech", "MBA"],
        'score':[90, 40, 80, 98]}

# creating a dataframe with boolean index
df = pd.DataFrame(dict, index = [True, False, True, False])

# accessing a dataframe using .loc[] function
print(df.loc[True])
        name  degree  score
True  aparna     MBA     90
True  sudhir  M.Tech     80
همان طور که قبلاً گفته شد، iloc تنها مقادیر عددی را به عنوان پارامتر ورودی می پذیرد، پس در نتیجه مقدار Boolean را نمی توان به آن داد.
دسترسی به عناصر دیتافریم (Dataframe) با اپراتورهای منطقی روی ستون ها وسطرها
می توان برای دسترسی به عناصر برمبنای مقادیرشان به کمک اپراتورهای منطقی همچون ==، <=، >= و != فیلترهایی تعریف کرد. خروجی چنین فیلترهایی مجموعه ای بولین با مقادیر True و False است.
# importing pandas as pd
import pandas as pd

# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["BCA", "BCA", "M.Tech", "BCA"],
        'score':[90, 40, 80, 98]}

# creating a dataframe
df = pd.DataFrame(dict)

# using a comparsion operator for filtering of data
print(df['degree'] == 'BCA')
0     True
1     True
2    False
3     True
Name: degree, dtype: bool
همین فیلترها را بر روی index یا همان برچسب سطرها نیز می توان اعمال کرد. مثال زیر را در نظر بگیرید:
# importing pandas as pd
import pandas as pd

# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["BCA", "BCA", "M.Tech", "BCA"],
        'score':[90, 40, 80, 98]}


df = pd.DataFrame(dict, index = [0, 1, 2, 3])

print(df[df.index>=2])
     name  degree  score
2  sudhir  M.Tech     80
3   Geeku     BCA     98
مرتب سازی عناصر دیتافریم (Dataframe) در کتابخانه Pandas
برای مرتب سازی صعودی یا نزولی داده های ستون های دیتافریم (Dataframe) از تابع sort_values() استفاده می کنیم. قاعده ی کلی به شکل زیر است:
DataFrame.sort_values(by, axis=0, ascending=True, inplace=False, kind=’quicksort’, na_position=’last’)
تمامی پارامترها به جز by دارای مقادیر پیش فرض اند.
by: نام یک یا مجموعه ای از ستون ها برای مرتب سازی داده ها بر مبنای آن ستون ها است.
axis: عدد 0 یا عبارت 'index' برای سطر و 1 یا 'columns' برای ستون.
ascending: یک مقدار بولین که اگر True بود صعودی، و اگر False بود نزولی مرتب می کند.
inplace: یک مقدار بولین است. اگر True بود در دیتافریم (Dataframe) انتقالی به تابع، تغییراتی ایجاد می کند.
kind: یک مقدار رشته ای است که می تواند سه مقدار 'quicksort'، 'mergesort' و یا 'heapsort' را بگیرد و الگوریتم مرتب سازی بر اساس آن عمل کند.
na_position: می تواند یکی از دو مقدار رشته ای 'last' یا 'first' را بگیرد و بر اساس آن تعیین کند که مکان مقادیر NAN یا همان تهی، پس از مرتب سازی در ابتدای جدول قرار گیرد یا در انتهای آن.
دیتافریم (Dataframe) برگشت داده شده از تابع مرتب سازی، همان ابعاد و shape دیتافریم (Dataframe) اولیه را دارد. فرض کنید دیتافریمی (Dataframe) با نام data به شکل زیر داریم و می خواهیم براساس ستون name سطرها را مرتب کنیم.
| name | Age | |
|---|---|---|
| 0 | John | 25 |
| 1 | Smith | 30 |
| 2 | Paul | 50 |
| 3 | Adam | 26 |
| 4 | Smith | 11 |
# importing pandas package
import pandas as pd

# sorting data frame by name
data.sort_values("name", axis = 0, ascending = True,
                 inplace = True, na_position ='last')

# display
data
| name | Age | |
|---|---|---|
| 3 | Adam | 26 |
| 0 | John | 25 |
| 2 | Paul | 50 |
| 1 | Smith | 30 |
| 4 | Smith | 11 |
کار با مقادیر ناموجود یا تهی در دیتافریم (Dataframe)
داده ی ناموجود یا تهی (Missing Values) زمانی رخ می دهد که یک یا چند آیتم مقداردهی نشده باشند و یا اطلاعاتی در خصوص آن ها در دست نباشد. داده ی ناموجود در تحلیل داده های سناریوهای واقعی مسأله ی مهمی است. در پانداس از آن تحت عنوان NA NotAvailible نیز یاد می شود.
کنترل مقادیر ناموجود با is null و not null
برای کنترل مقادیر ناموجود در دیتافریم (Dataframe) کتابخانه pandas (پانداس) می توانیم از is null و not null استفاده کنیم. هردو تابع در کنترل اینکه آیا مقدار یک آیتم NAN هست یا نه؛ کمک می کنند. این توابع در سری ها هم می توانند برای یافتن مقادیر NAN به کار گرفته شوند. خروجی این توابع مقادیر بولین است.
# importing pandas as pd
import pandas as pd

# importing numpy as np
import numpy as np

# dictionary of lists
dict = {'First Score':[100, 90, np.nan, 95],
        'Second Score': [30, 45, 56, np.nan],
        'Third Score':[np.nan, 40, 80, 98]}

# creating a dataframe from list
df = pd.DataFrame(dict)

# using isnull() function
df.isnull()
| First Score | Second Score | Third Score | |
|---|---|---|---|
| 0 | False | False | True |
| 1 | False | False | False |
| 2 | True | False | False |
| 3 | False | True | False |
مقداردهی مقادیر ناموجود با fillna، replace و interpolate
به منظور پرکردن و مقداردهی مقادیر تهی در دیتابیس از توابع fllna، replace و interpolate استفاده می کنیم که این توابع مقادیر NAN را با مقادیر تولیدی خود جایگزین می کنند. در کد زیر به کمک متد fillna مقادیر تهی را با صفر جایگزین می کنیم.
# importing pandas as pd
import pandas as pd

# importing numpy as np
import numpy as np

# dictionary of lists
dict = {'First Score':[100, 90, np.nan, 95],
        'Second Score': [30, 45, 56, np.nan],
        'Third Score':[np.nan, 40, 80, 98]}

# creating a dataframe from dictionary
df = pd.DataFrame(dict)

# filling missing value using fillna()
df.fillna(0)
| First Score | Second Score | Third Score | |
|---|---|---|---|
| 0 | 100.0 | 30.0 | 0.0 |
| 1 | 90.0 | 45.0 | 40.0 |
| 2 | 0.0 | 56.0 | 80.0 |
| 3 | 95.0 | 0.0 | 98.0 |
حذف مقادیر null با تابع dropna
به منظور حذف مقادیر NAN از دیتافریم (Dataframe) از تابع dropna استفاده می کنیم. این تابع سطرها و ستون های NAN را با شیوه های مختلف حذف می کند. دیتافریم (Dataframe) df را به شکل زیر داریم:
# importing pandas as pd
import pandas as pd

# importing numpy as np
import numpy as np

# dictionary of lists
dict = {'First Score':[100, 90, np.nan, 95],
        'Second Score': [30, np.nan, 45, 56],
        'Third Score':[52, 40, 80, 98],
        'Fourth Score':[np.nan, np.nan, np.nan, 65]}

# creating a dataframe from dictionary
df = pd.DataFrame(dict)

df
| First Score | Second Score | Third Score | Fourth Score | |
|---|---|---|---|---|
| 0 | 100.0 | 30.0 | 52 | NaN |
| 1 | 90.0 | NaN | 40 | NaN |
| 2 | NaN | 45.0 | 80 | NaN |
| 3 | 95.0 | 56.0 | 98 | 65.0 |
در کد زیر سطرهایی که حداقل یک مقدار NAN دارند را حذف می کند.
# importing pandas as pd
import pandas as pd

# importing numpy as np
import numpy as np

# dictionary of lists
dict = {'First Score':[100, 90, np.nan, 95],
        'Second Score': [30, np.nan, 45, 56],
        'Third Score':[52, 40, 80, 98],
        'Fourth Score':[np.nan, np.nan, np.nan, 65]}

# creating a dataframe from dictionary
df = pd.DataFrame(dict)

# using dropna() function
df.dropna()
خروجی به شکل زیر خواهد بود:
| First Score | Second Score | Third Score | Fourth Score | |
|---|---|---|---|---|
| 3 | 95.0 | 56.0 | 98 | 65.0 |
حال کدی می نویسیم که با آن سطری را که همه ی عناصر آن صفر باشد را حذف کنیم. فرض کنید دیتافریم (Dataframe) زیر را داریم که سطر دوم آن همگی NAN است:
# importing pandas as pd
import pandas as pd

# importing numpy as np
import numpy as np

# dictionary of lists
dict = {'First Score':[100, np.nan, np.nan, 95],
        'Second Score': [30, np.nan, 45, 56],
        'Third Score':[52, np.nan, 80, 98],
        'Fourth Score':[np.nan, np.nan, np.nan, 65]}

df = pd.DataFrame(dict)

# using dropna() function
df.dropna(how = 'all')
خروجی حاصل به شکل زیر است:
| First Score | Second Score | Third Score | Fourth Score | |
|---|---|---|---|---|
| 0 | 100.0 | 30.0 | 52.0 | NaN |
| 2 | NaN | 45.0 | 80.0 | NaN |
| 3 | 95.0 | 56.0 | 98.0 | 65.0 |
حذف ستونی با حداقل یک مقدار null
مجموعه داده ی زیر را در نظر بگیرید:
# importing pandas as pd
import pandas as pd

# importing numpy as np
import numpy as np

# dictionary of lists
dict = {'First Score':[100, np.nan, np.nan, 95],
        'Second Score': [30, np.nan, 45, 56],
        'Third Score':[52, np.nan, 80, 98],
        'Fourth Score':[60, 67, 68, 65]}

# creating a dataframe from dictionary
df = pd.DataFrame(dict)

df
| First Score | Second Score | Third Score | Fourth Score | |
|---|---|---|---|---|
| 0 | 100.0 | 30.0 | 52.0 | 60 |
| 1 | NaN | NaN | NaN | 67 |
| 2 | NaN | 45.0 | 80.0 | 68 |
| 3 | 95.0 | 56.0 | 98.0 | 65 |
دستور( dropna(axis=1 منجر به حذف ستون های اول و دوم وسوم خواهد شد. (وقتی axis را برابر 1 قرار می دهیم یعنی متد روی ستون ها کار می کند و اگر صفر باشد روی سطرها):
# importing pandas as pd
import pandas as pd

# importing numpy as np
import numpy as np

# dictionary of lists
dict = {'First Score':[100, np.nan, np.nan, 95],
        'Second Score': [30, np.nan, 45, 56],
        'Third Score':[52, np.nan, 80, 98],
        'Fourth Score':[60, 67, 68, 65]}

# creating a dataframe from dictionary
df = pd.DataFrame(dict)

# using dropna() function
df.dropna(axis = 1)
| Fourth Score | |
|---|---|
| 0 | 60 |
| 1 | 67 |
| 2 | 68 |
| 3 | 65 |
جمع بندی:
در این مقاله به معرفی کتابخانه Pandas در پایتون پرداختیم. پانداس یک کتابخانه ی متن باز است که برای کار بر روی داده های برچسب دار و رابطه ای طراحی شده است. چنین ساختار داده ای باعث می شود تا به کمک عملیات تعریف شده بر روی داده های رابطه ای تحلیل سودمندی روی داده ها انجام داد. این کتابخانه به خاطر قابلیت سرعت و قدرت خوب پردازشی در علم داده بسیار پرکاربرد است و توابع و متدهای فراوانی را فراهم کرده است. با مطالعه ی این مقاله و انجام مثال های آن با این فریم ورک آشنا شده و قادر به شروع انجام پروژه ی خود خواهید بود.
اگر دوست داری به یک متخصص پایتون وب تبدیل بشی و در شرکت های معتبر مشغول به کار با درآمد بالا بشی ، شرکت در دوره جامع آموزش پایتون را پیشنهاد می کنیم.

عالییییی بود! ممنون
سلام
با تشکر از آموزش شما
این دستور کار نمیکنه نیاز به دو تا کروشه دیگه هم داره: ['df.loc['Person1','Person2
به این صورت کار میکنه:
[['df.loc[['Person1','Person2
سلام. ممنون از دقت و توجه شما. اصلاح شد.
عالی بود! ممنون.
سلام خسته نباشید اموزشتون عالی بود.ببخشید اون ستون سمت چپ که اعداد از 0 تا 3 توش هستن رو میشه از طریق کد پاک کرد؟با سپاس فراوان.
درود
به اون اعداد ایندکس گفته میشه و صرفا حالت نمایشی دارند. با این کد، میتونید در پرینت پاکشون کنید:
print(df.to_string(index=False))
سلام.ممنون از نکات خوبتون...چطور میتونیم یک ستون از دیتافریم را در عددی ضرب یا تقسیم یا بطور کلی عملیات ریاضی روی آن انجام بدیم و بصورت inplace ستون نهایی در دیتافریم رو داشته باشیم؟
درود
1. فرض کنید یک ستون با نام b دارید و میخواید یک عملیات ریاضی : مثلا 10 واحد اضافه کنید. به اینصورت میشه: df['b'] + 10
2. اگر میخواید مقدار جدید جایگزین ستون قبلی بشه کافیه به این صورت بنویسید: df['b'] += 10 اگر نه که یک ستون جدید تعریف کنید و عبارت بالا رو بهش اساین کنید.
پایدار باشید
سلام من اگر بخوام دو تا دیتا فریم رو به هم وصل کنم یعنی مثلا اولی از ایندکس 0 تا 10 هست دومی 0 تا 5 می خوام دومی بیاد زیر اول و در کل یه دیتا فریم با ایندکس 0 تا 15 به من بده ، باید چ کنم ؟
درود
جوابهای این سوال رو مطالعه کنید.
سلام و وقت بخیر
چطور میشه در ستون یک دیتا فریم داده هارو دوتا دوتا باهم مقایسه کرد و ماکسیمم آنهارو برگرداند؟
در کل چطور میشه با یک ستون از دیتا فریم کار کرد؟
درود
بله شدنی هست. پیشنهاد میکنم که این تاپیک استک رو مطالعه کنید جوابتون به طور کامل درونش هست.
سلام متشکرم از آموزشتون.
چطور میتونم در یک ستون از دیتا فریم هر داده رو منهای داده قبلش کنم و در ستونی جدید قرار بدم؟
درود
باید از حلقه کمک بگیرید. این تاپیک استک درمورد اضافه کردن مقدار هست به راحتی میتونید بجاش از منها استفاده کنید.
سلام ممنون از محتوای خوبتون
من اگه یک دیتایی داشته باشم که مقادیر ورودی به انبار و دیتایی داشته باشم که مقادیر خروجی از انبار باشن بخوام دیتایی بسازم که مقادیر خروجی به نسبت موجودی انبار (به معیار تاریخ) باشه چه نوع کدی باید بزنم؟
درود
معمولترین کار این هست که دیتای ورودی و خروجی رو در دو دیتافریم مختلف بریزید و این دو رو براساس تاریخ مرتب کنید. بعد هر عضو رو با نظیرش مقایسه کنید.